VLA / WAM 模型监督微调#
监督微调(SFT)是具身强化学习的标准冷启动步骤:一个良好的 SFT 检查点能显著缩短 RL 探索时间并提升最终策略效果。本类示例汇总了 RLinf 在 VLA / WAM 模型上的全量与 LoRA SFT 配方,以及面向多模态后训练的 VLM SFT。
完成本节的 SFT 后,可继续阅读 具身模型(以模型为主线的 RL 微调)或 基于模拟器的具身强化学习(以基准为主线的 RL 微调)以进一步用 RL 提升所得检查点。
OpenPI 监督微调
支持 OpenPI 全量 SFT 与 LoRA 微调,作为强化学习前置阶段
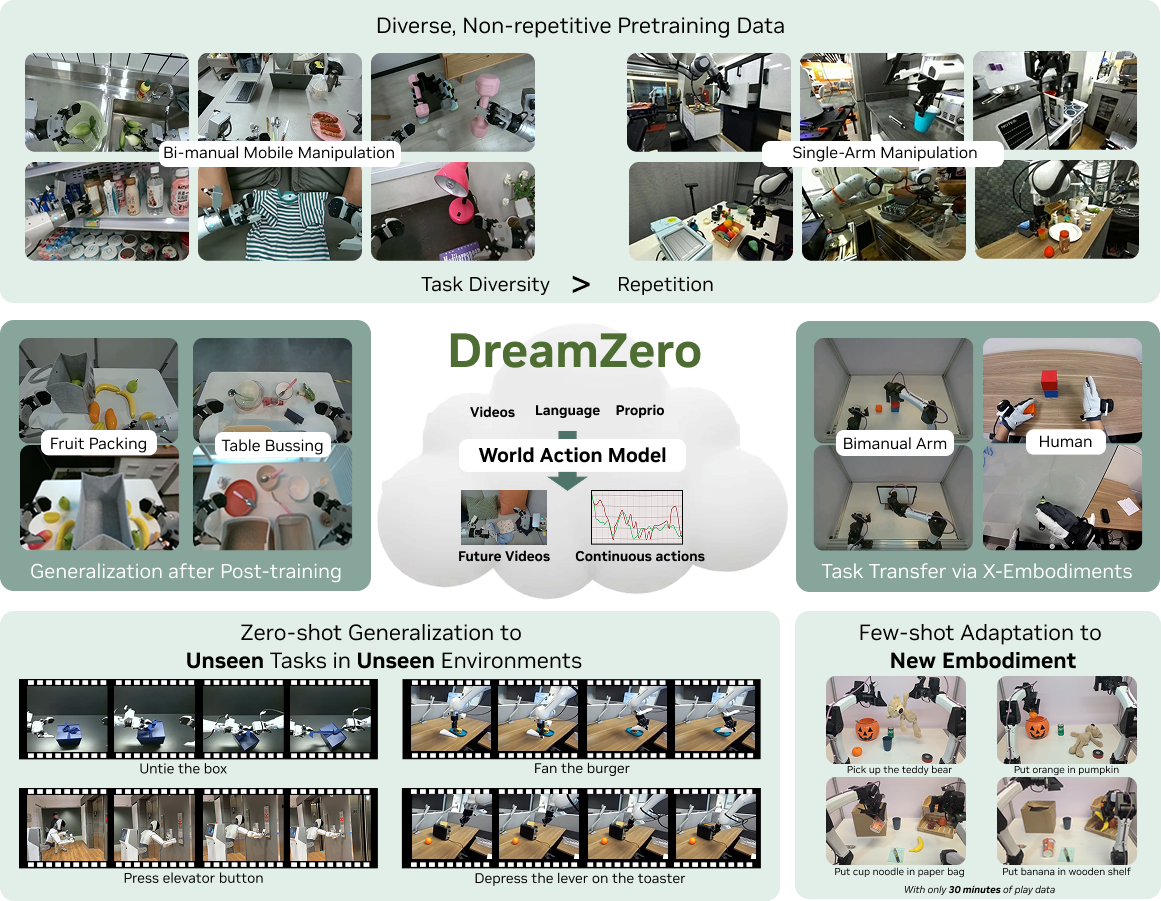
DreamZero 监督微调
面向 DreamZero 的全量与 mixture SFT(WAN2.1 / WAN2.2 主干)
FastWAM 评测与监督微调
在 LIBERO 上评测 FastWAM 并进行全参数 FSDP 监督微调
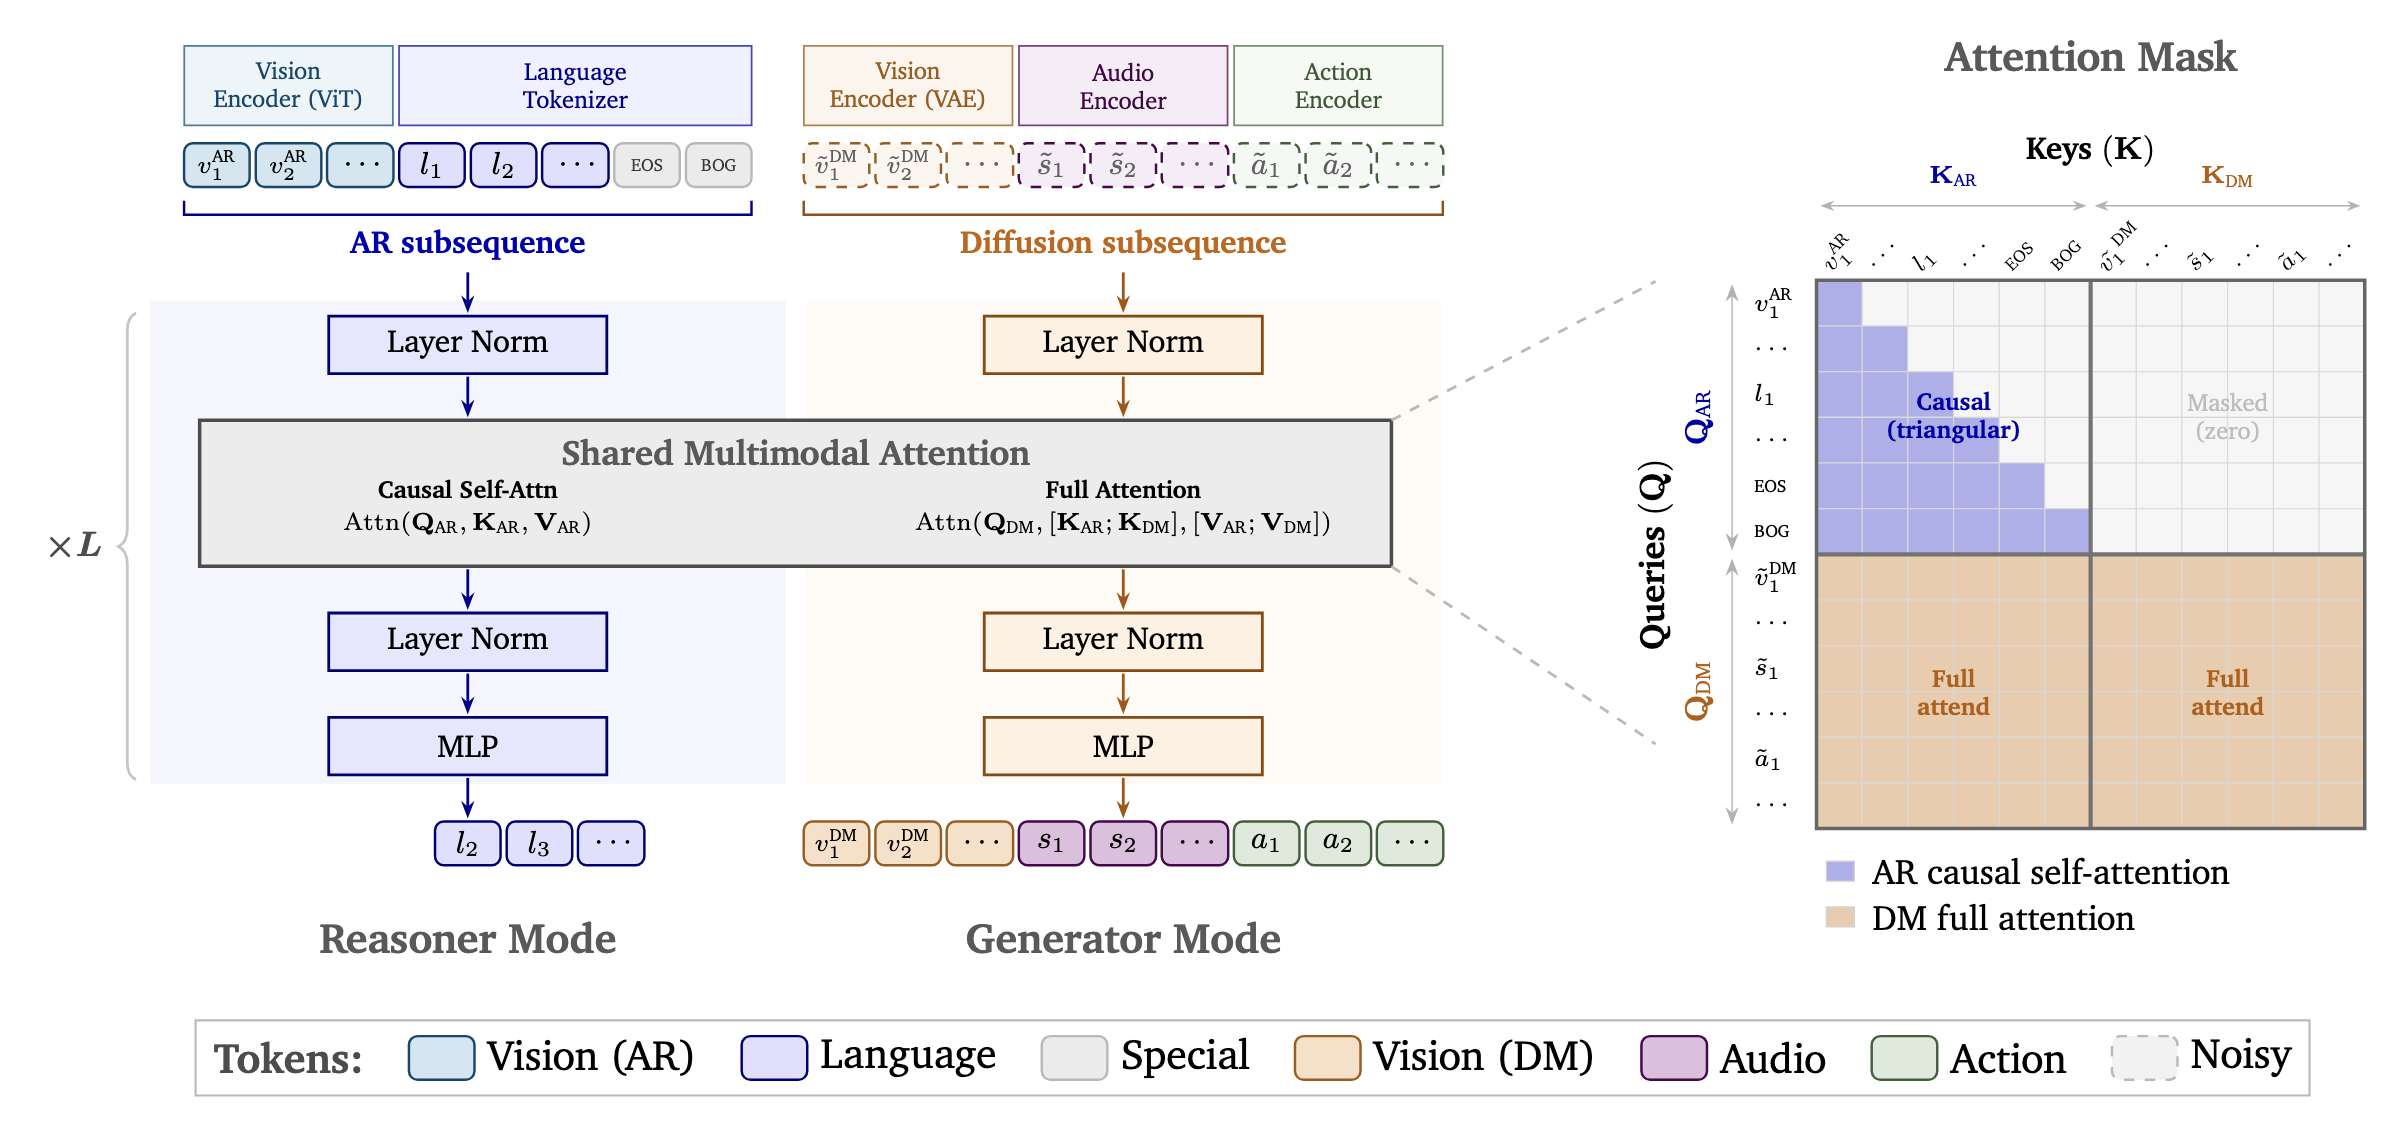
Cosmos3 监督微调
基于 NVIDIA Cosmos3-Nano(OmniMoT)的 LIBERO 动作策略 SFT
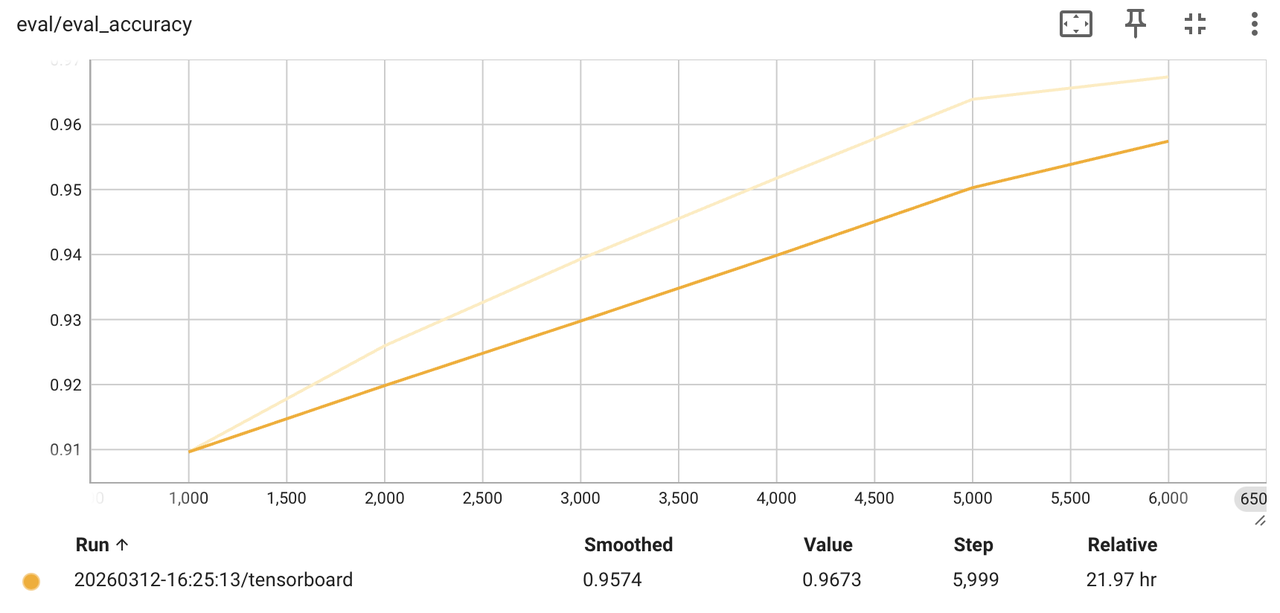
Qwen-VL
支持 Qwen 系列等 VLM 的全量监督微调与结果评估
具身策略的 DAgger 训练
通过专家重标注与回放缓冲区训练推进在线模仿学习