RL#
本类示例以 训练算法或方法 为主线,独立于具体基准或模型,覆盖离线 RL、模仿学习、仿真-真机协同训练以及残差 / 噪声空间策略调控。
如果你在思考 如何训练*(PPO 还是 SAC?IQL 还是 DAgger?RECAP?),而不是要在 *什么任务上 训练或 微调哪个模型,请参考本节。
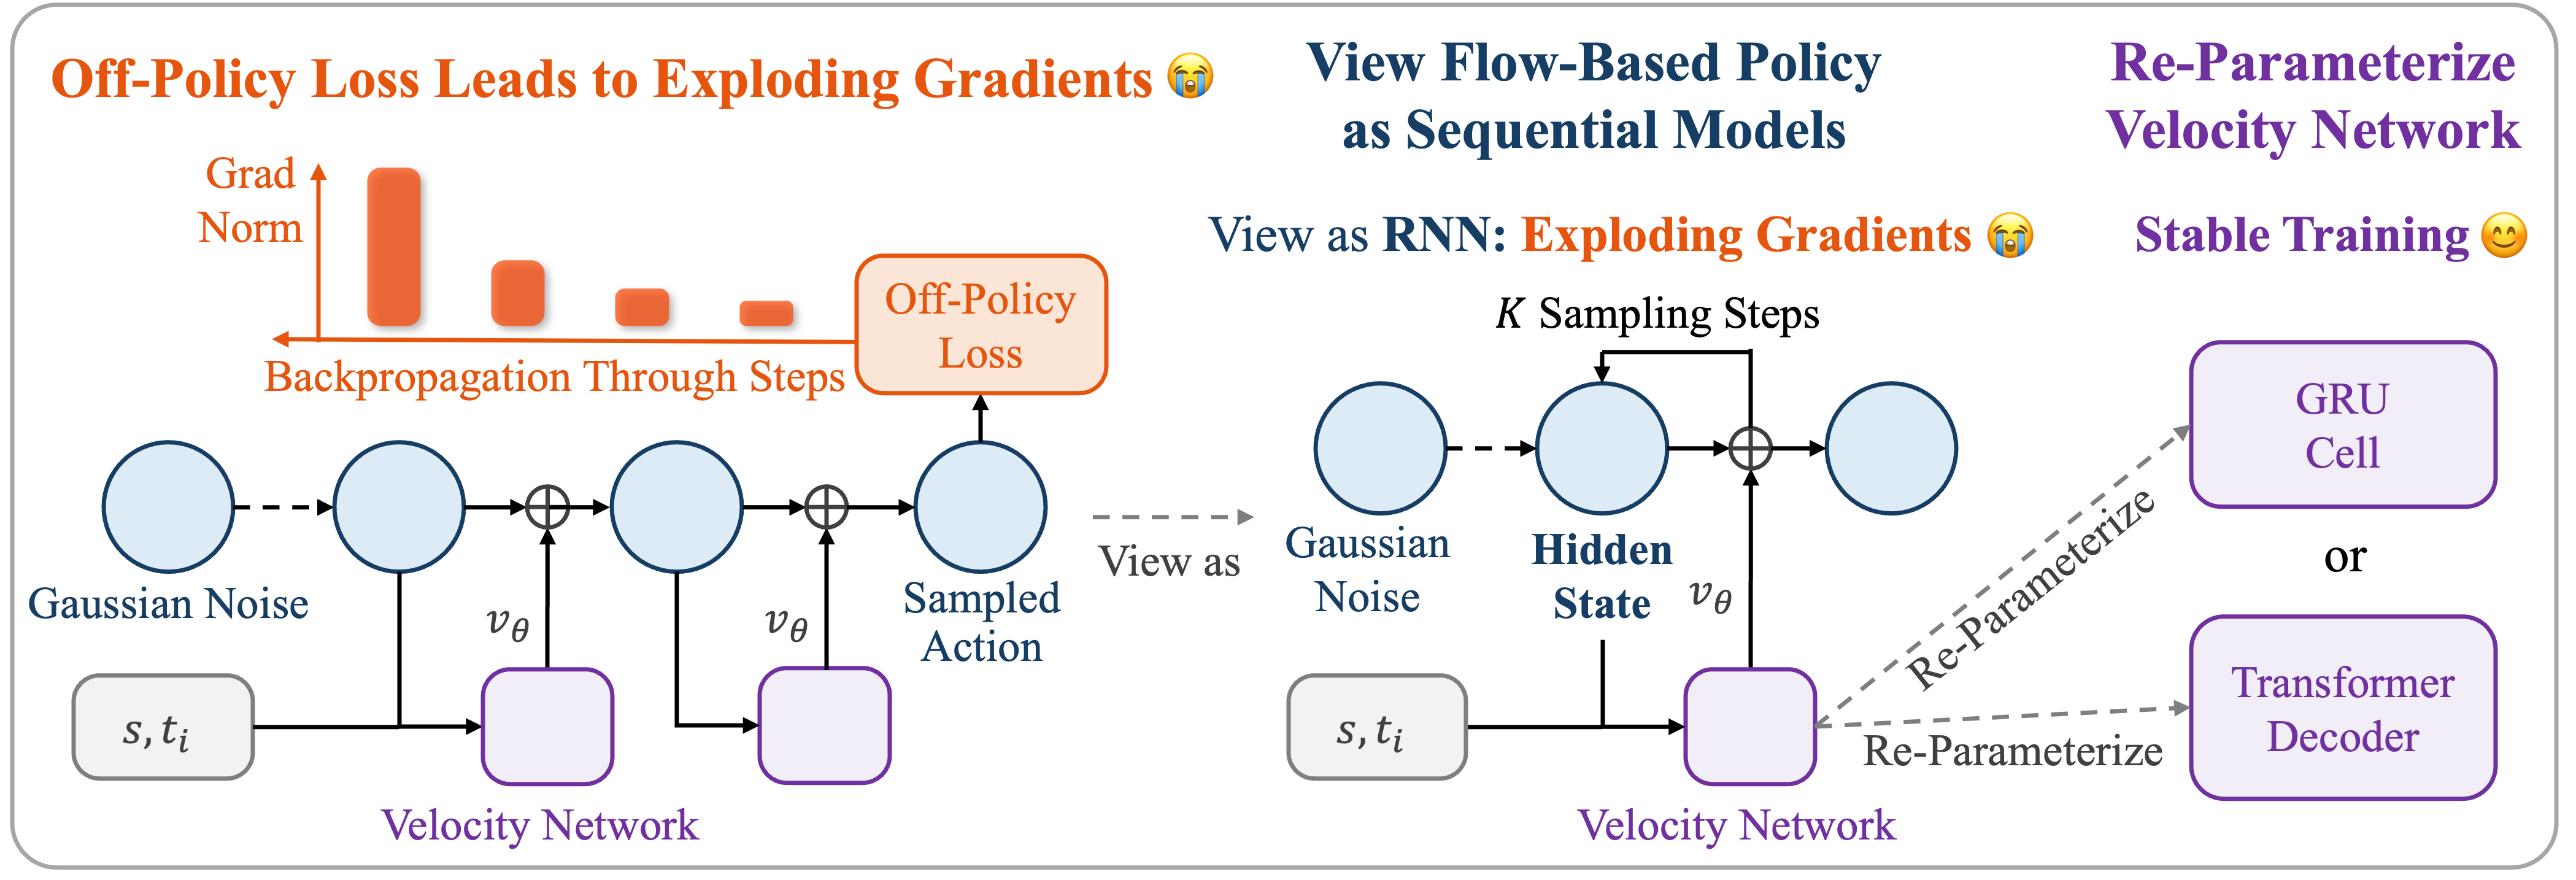
SAC-Flow 策略训练
使用 SAC 训练 Flow Matching 策略 (Sim & Real)
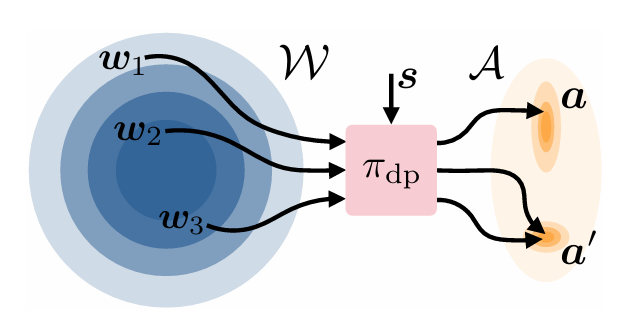
DSRL:Pi0 噪声空间强化学习
用轻量级 SAC 智能体在噪声空间引导冻结的 Pi0 扩散策略
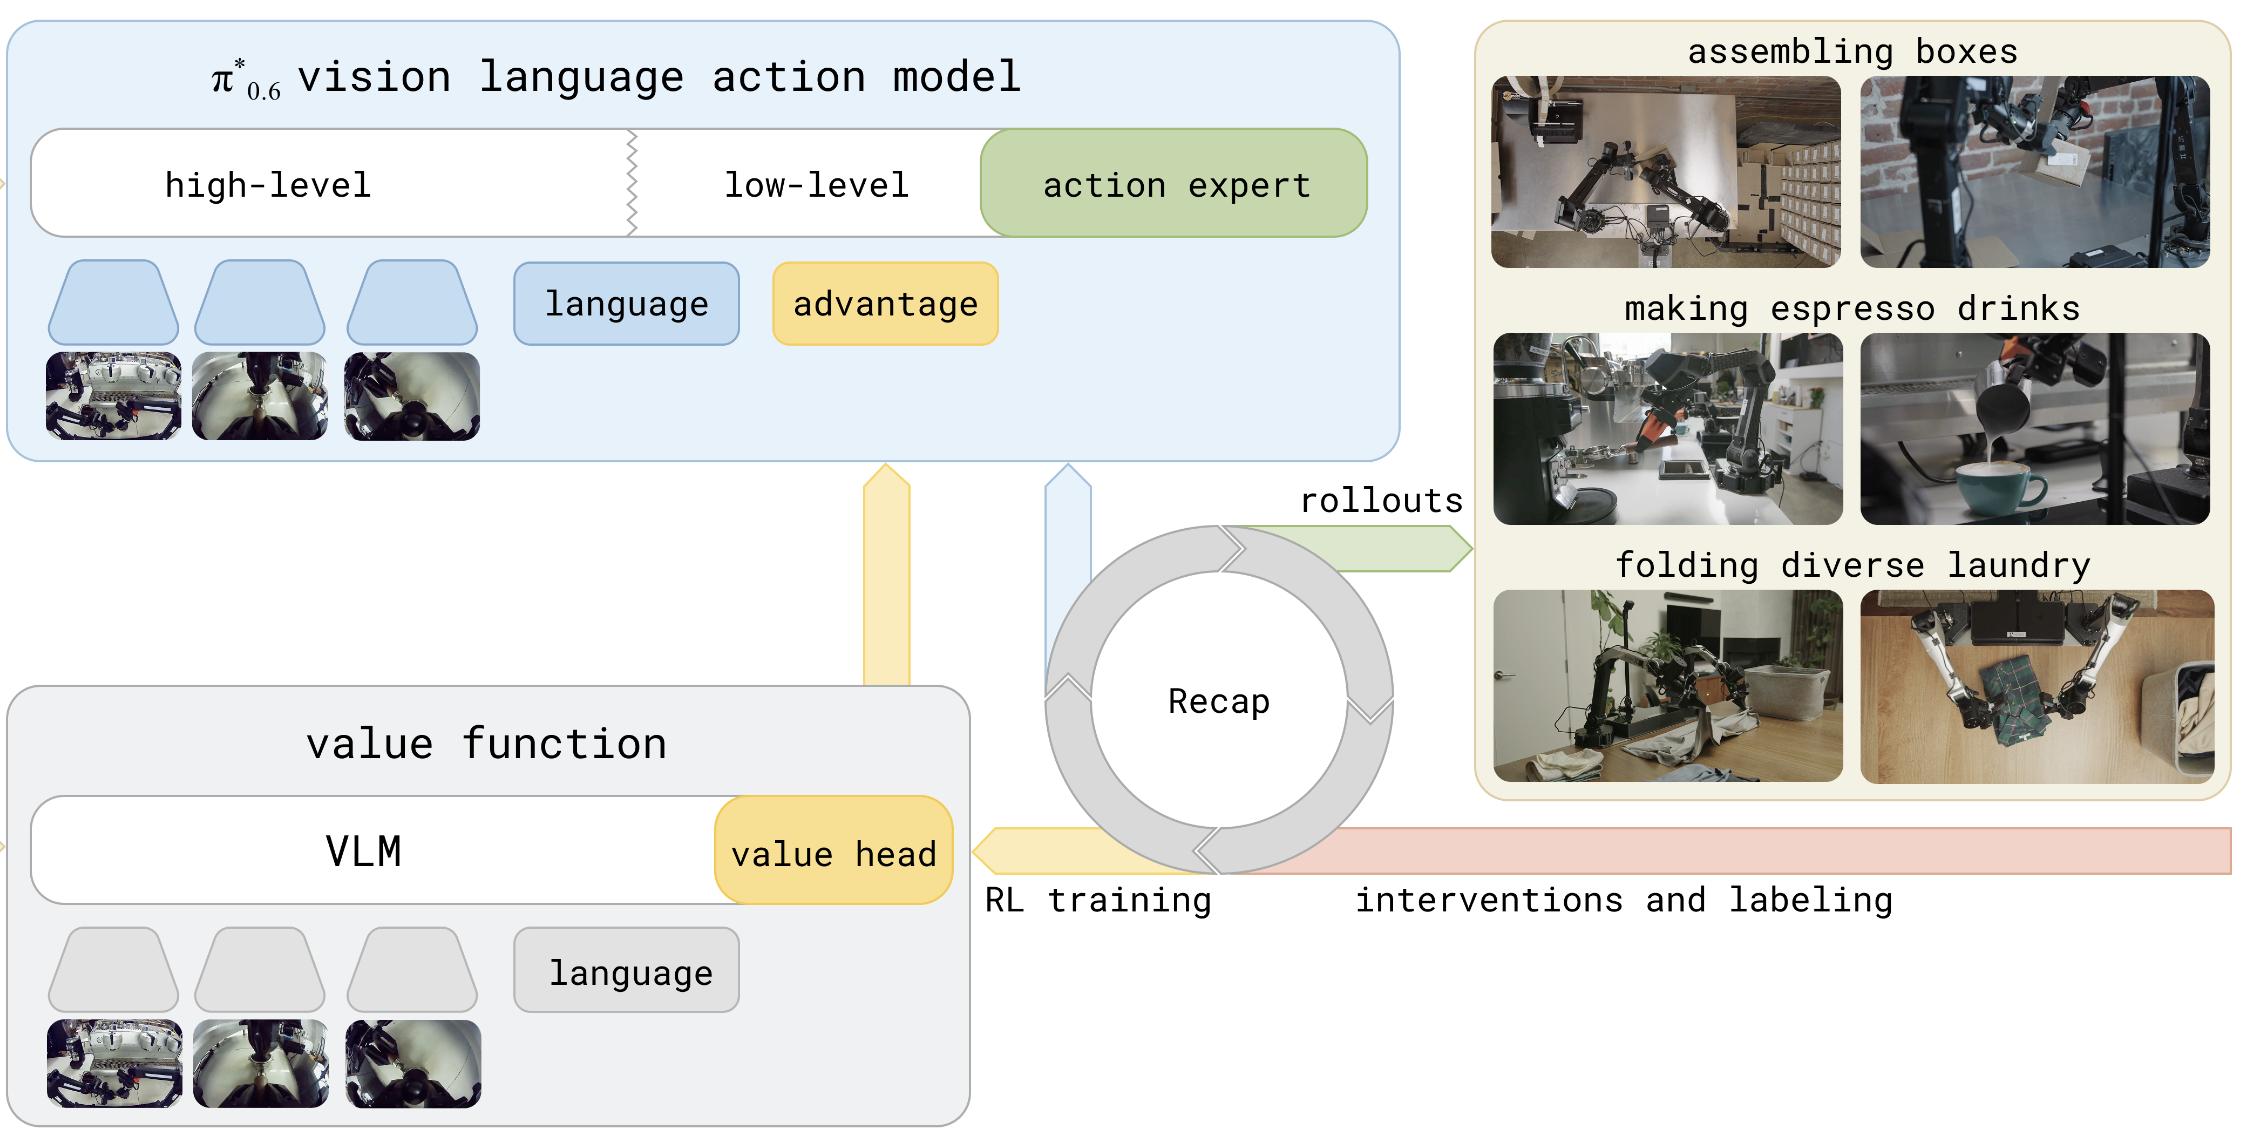
RECAP:离线优势条件策略优化
基于优势引导的离线策略优化
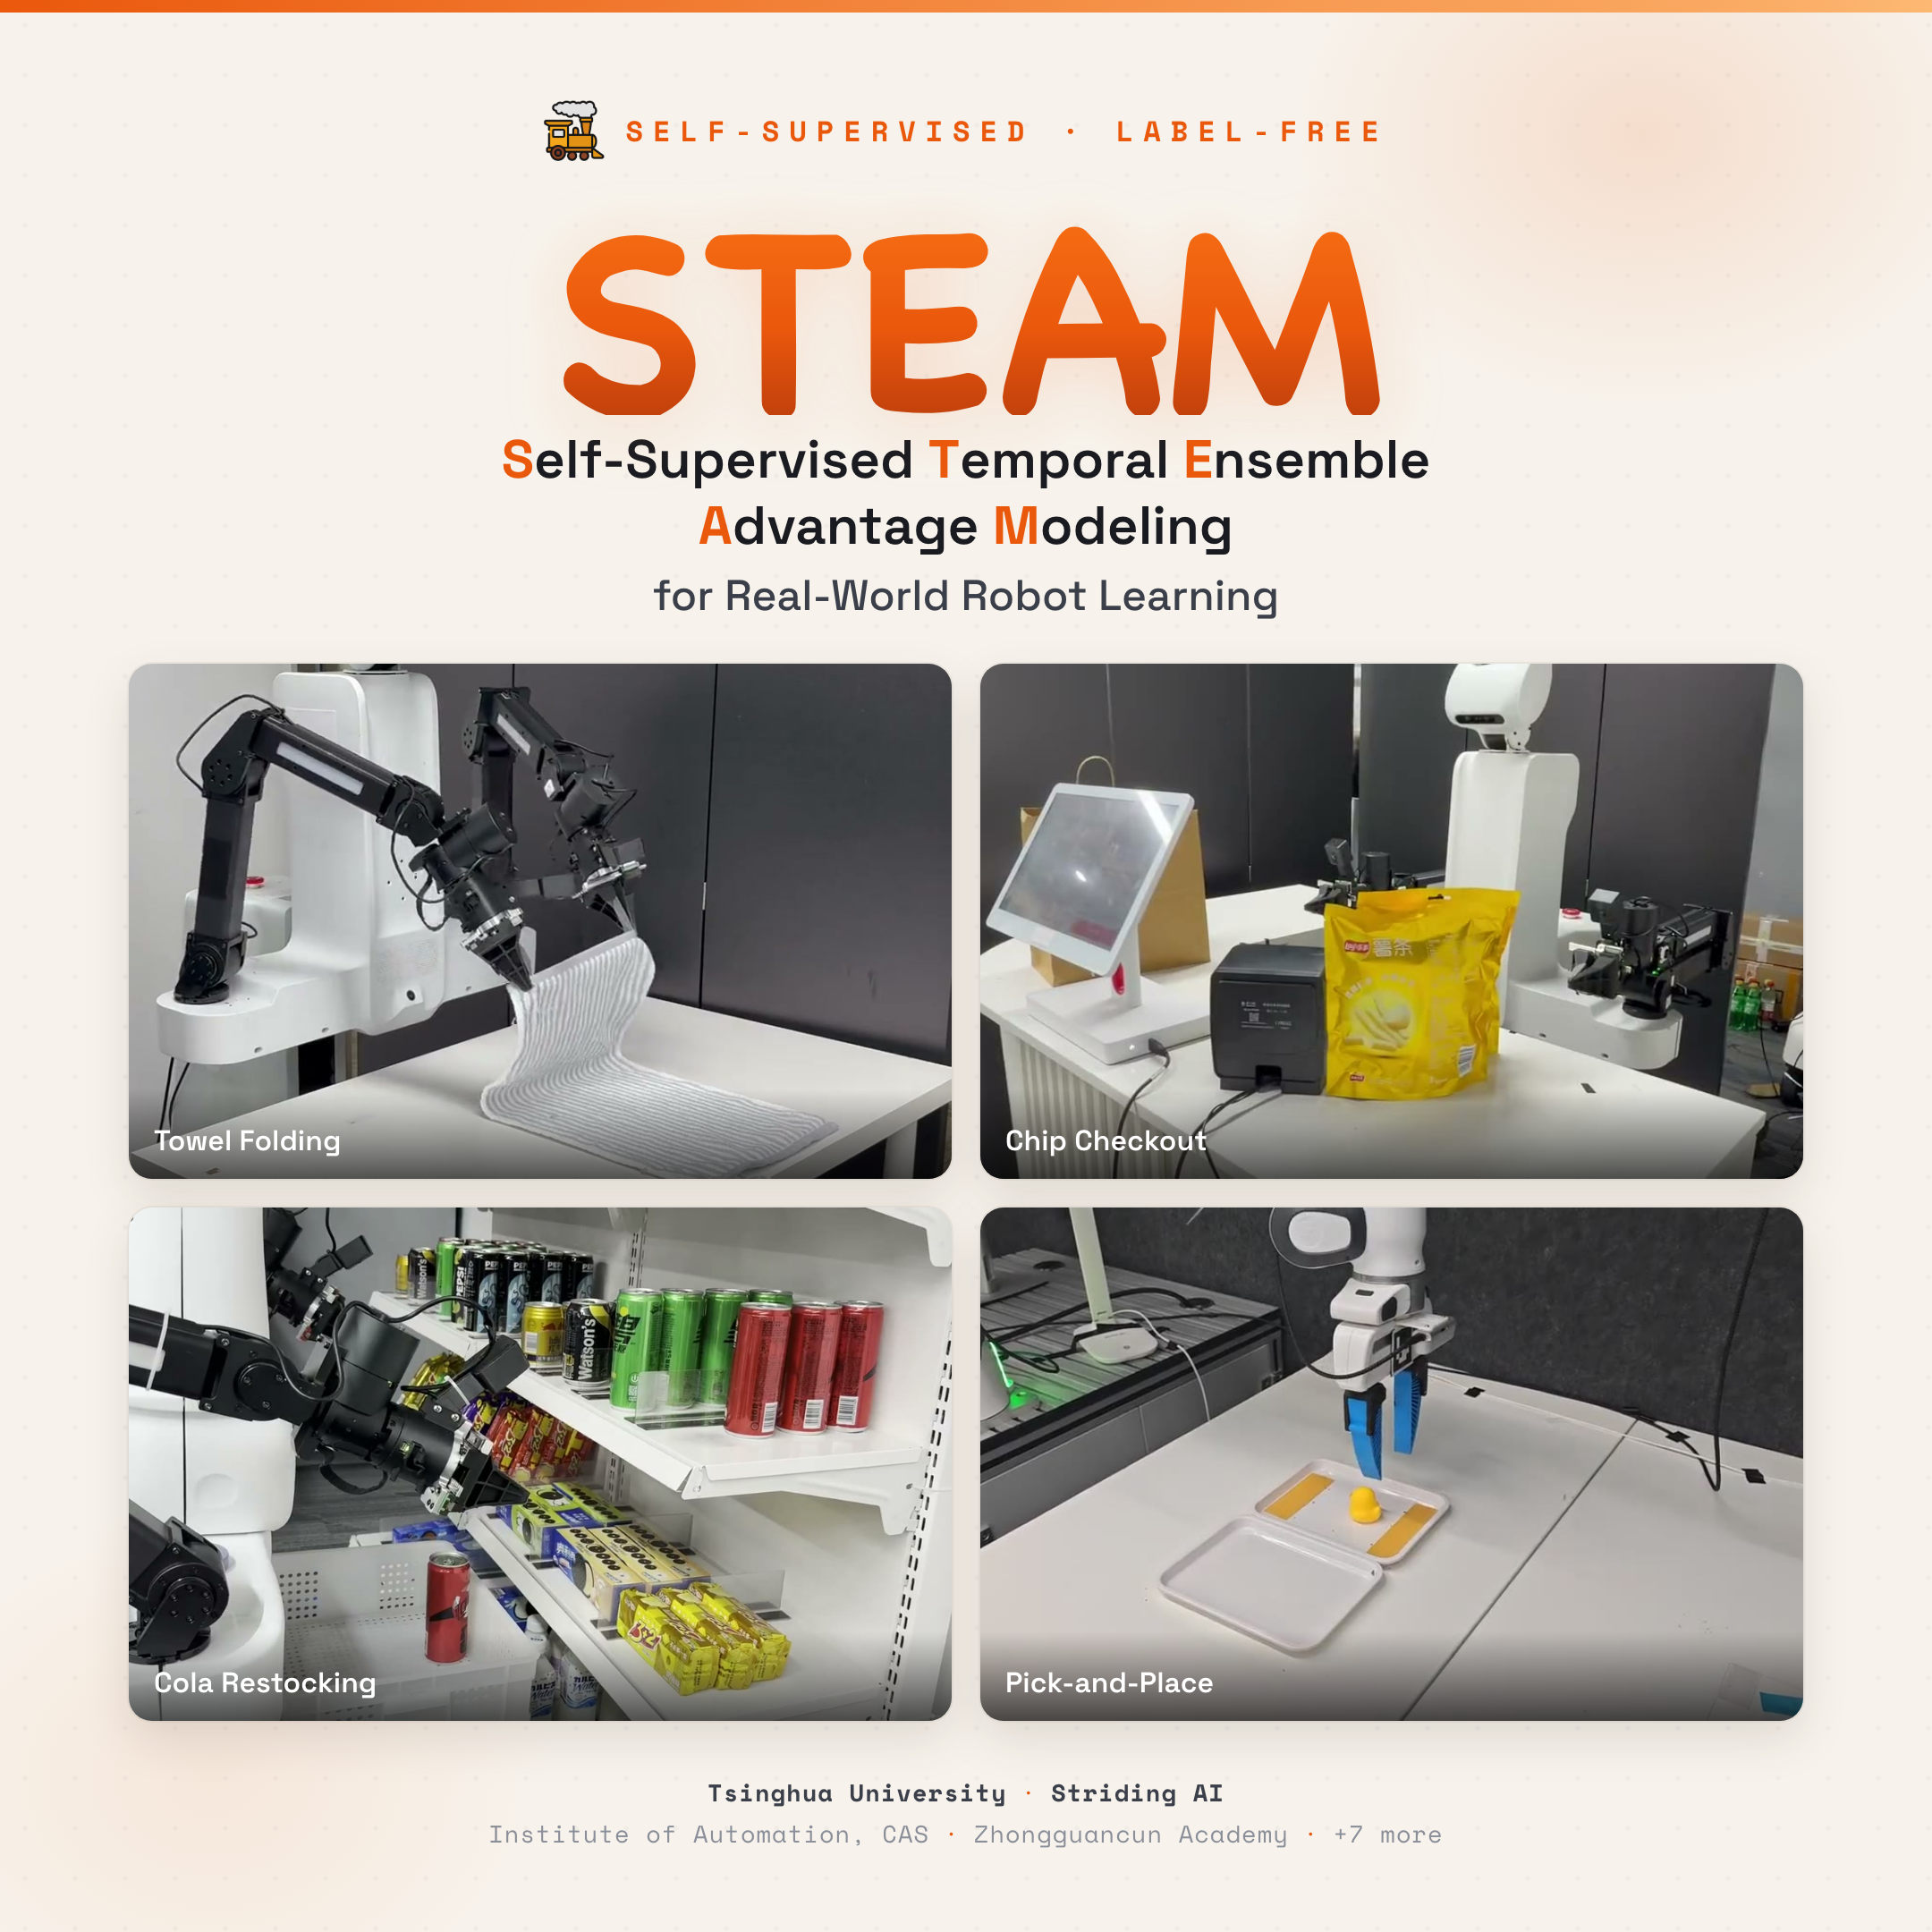
STEAM:集成优势建模
用集成优势预测器进行保守样本评估
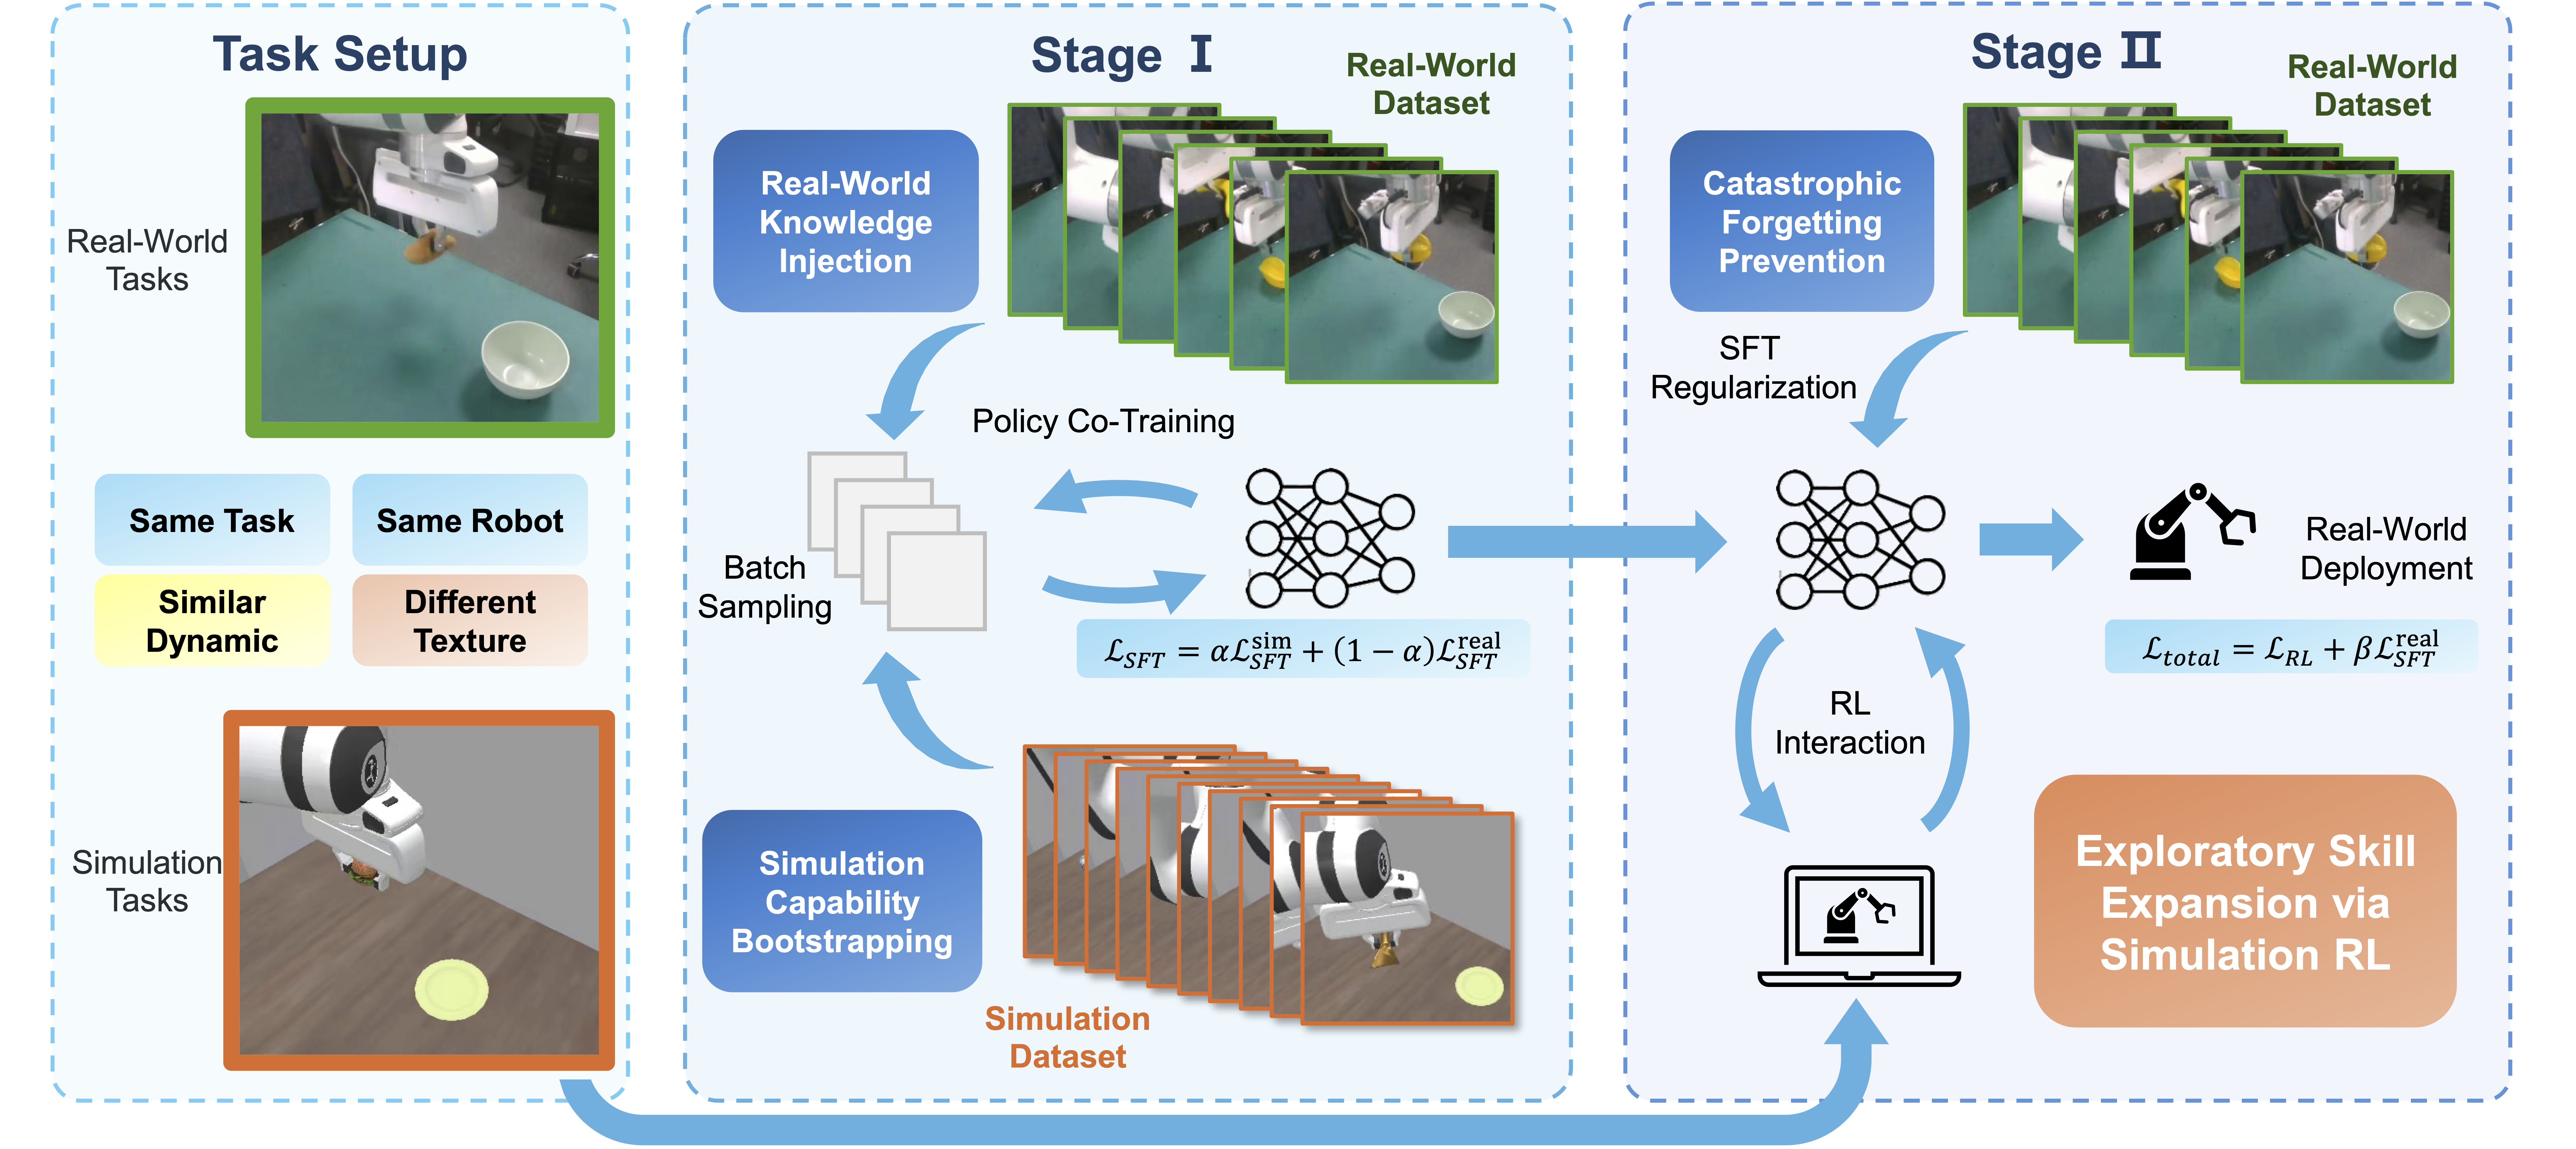
仿真-真机协同训练
仿真 PPO + 真机 SFT,提升 Sim-to-Real 迁移
基于 D4RL 基准的离线强化学习
支持 D4RL 场景的 IQL 离线训练
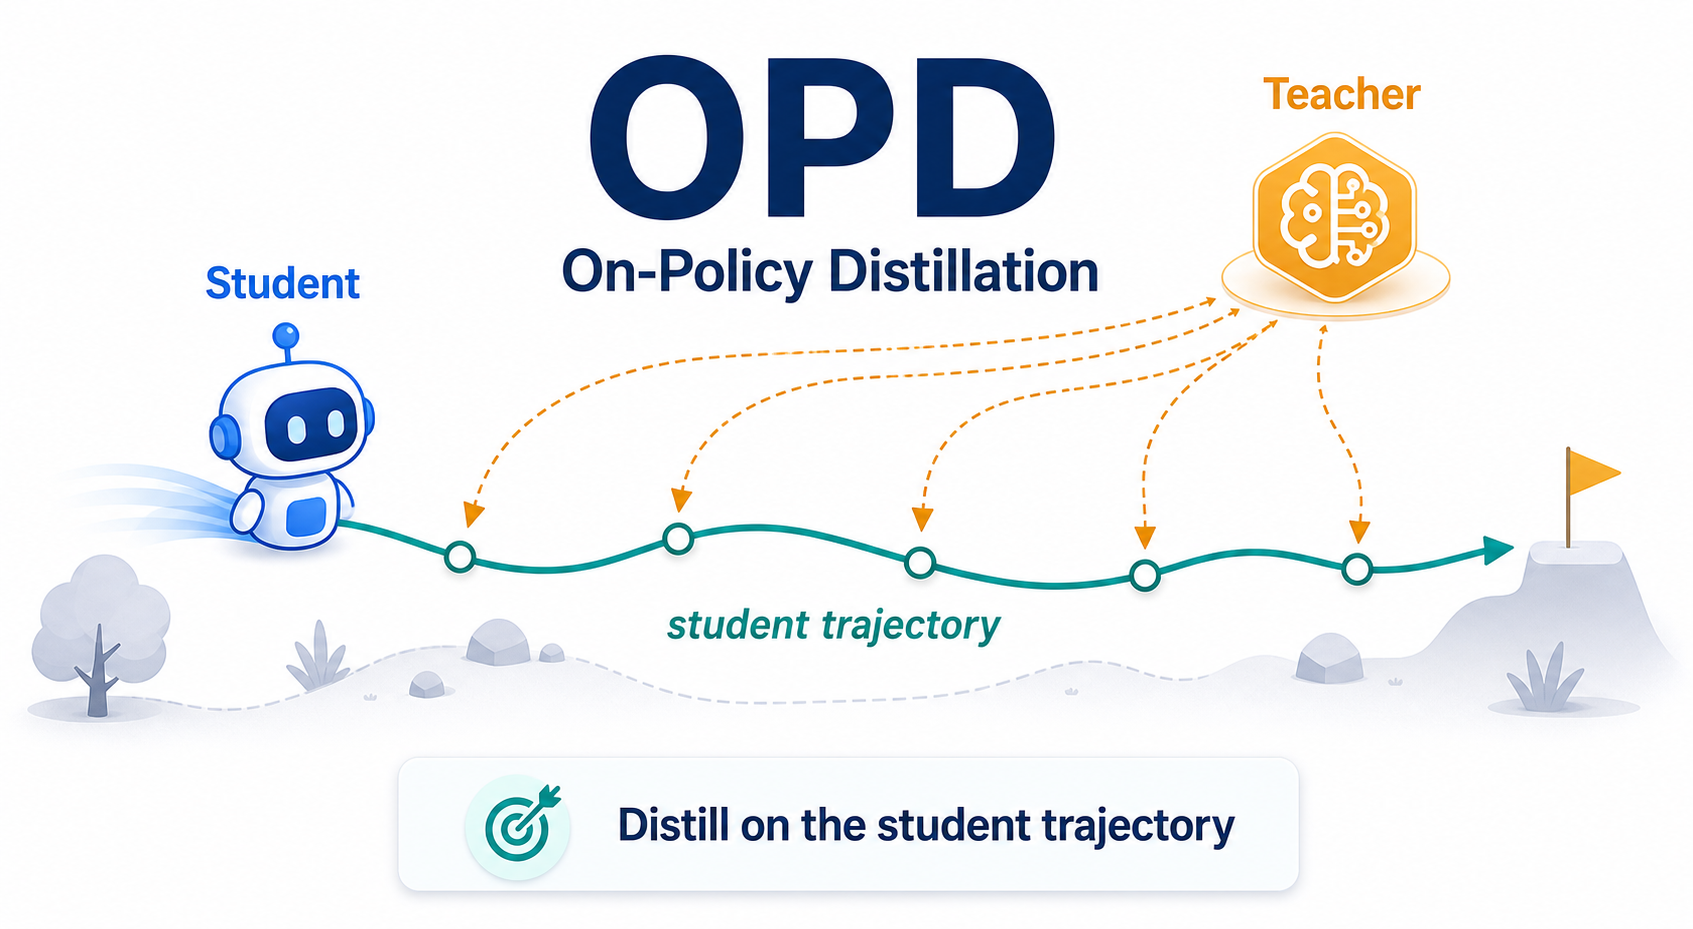
OPD:OpenVLA-OFT 在线策略蒸馏
在 student on-policy 动作 token 上用 teacher logprob 进行蒸馏
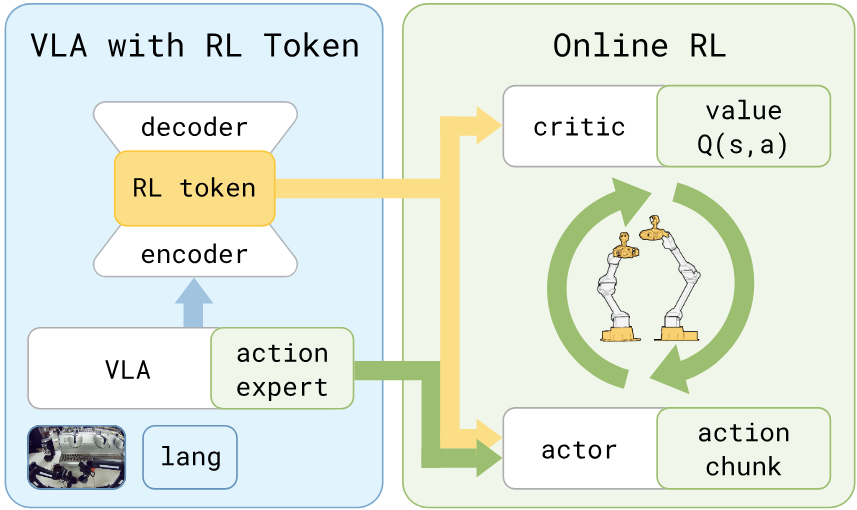
RL Token
借助 VLA prefix 特征启动在线 RL,并训练轻量级 actor-critic