Moonlight-16B GRPO 训练#
使用 GRPO 在数学数据上训练 Moonlight-16B-A3B-Instruct 模型(DeepSeek-V3 架构:多头潜在注意力 MLA + MoE)。相比监督微调,强化学习能鼓励多样化的推理路径,同时优化最终答案的正确性。
概述#
本配方用于在 AReaL-boba 数学推理数据上、单机 8 卡(TP=8、EP=8,Megatron-Bridge actor)训练 Moonlight-16B-A3B-Instruct。
Moonlight-16B-A3B-Instruct(DeepSeek-V3 MLA + MoE,64 专家 / top-6,约 3B 激活)
GRPO,token 级 loss + minibatch 早停
AReaL-boba 数学推理数据
8×A100,Megatron 训练(TP=8、EP=8)
模型架构#
Moonlight-16B-A3B-Instruct 是 DeepSeek-V3 架构的混合专家模型:
多头潜在注意力(MLA) :低秩压缩 KV(
q_lora_rank/kv_lora_rank),降低 KV cache 占用。MoE :64 个路由专家(top-6 路由)+ 1 个共享专家;
first_k_dense_replace=1(第 0 层稠密,第 1-46 层 MoE)。MTP :多 token 预测头(
num_nextn_predict_layers=1);RL 中不训练。使用 precision-aware optimizer (Float8 master 权重)训练,提升显存效率。
actor 通过 Megatron-Bridge(megatron-bridge)把 HuggingFace 权重转换为 Megatron-Core 分片 checkpoint;rollout 使用 SGLang(DeepSeek-V2 后端,model_type: deepseek_v3),开启专家并行(ep_size == tp_size)。
数据集#
与通用 数学推理 配方相同:AReaL-boba-Data,含 prompt / solutions 字段。
若你的数据集字段名不同,参考该页面中 prompt_key / answer_key / apply_chat_template 的调整说明。
GRPO 原理#
我们采用 GRPO(Group Relative Policy Optimization),并做如下调整:
token 级 loss:不按整段回答平均 loss,而是按 token 平均(同 DAPO),避免长回答主导训练。
minibatch 早停:某 minibatch 内重要性比过大时丢弃该 minibatch,稳定训练。
奖励:最终 boxed/数值答案正确 +5;错误 -5。
环境安装#
前置:需安装 NVIDIA 驱动 ≥580 和 CUDA 13.3 工具链(nvcc)。
cd /path/to/RLinf
MEGATRON_PATH=/path/to/Megatron-LM-core0.18 \
bash requirements/install.sh agentic \
  --sglang 0.5.12 --torch 2.11.0 --transformers 5.6.0 \
  --no-apex --platform nvidia --use-mirror \
  --venv /opt/venv/reason_0512_v3
该命令创建 Python 3.12 虚拟环境并安装 agentic 栈:sglang 0.5.12 + torch 2.11+cu130 + TransformerEngine 2.17 + transformers 5.6 + megatron-bridge 0.5.0 wheel + flash-attn,并通过 MEGATRON_PATH 复用 Megatron-Core 0.18 clone。
启动训练#
1. 配置文件
examples/reasoning/config/math/moonlight-16b-grpo-megatron.yaml
(model_type: deepseek_v3,TP=8,EP=8,multi_latent_attention: True,
precision-aware optimizer,reward_type: math)。
2. 启动命令
cd /path/to/RLinf/ray_utils
rm -f ray_head_ip.txt
export TOKENIZERS_PARALLELISM=false
bash start_ray.sh
if [ "$RANK" -eq 0 ]; then
    bash check_ray.sh 8          # 集群内 GPU 数
    cd /path/to/RLinf
    bash examples/reasoning/run_main_grpo_math.sh moonlight-16b-grpo-megatron
else
    if [ "$RANK" -eq 1 ]; then sleep 3m; fi
    sleep 10d
fi
sleep 10d
可视化与结果#
训练监控:
tensorboard --logdir ./logs --port 6006
指标含义见 训练指标。
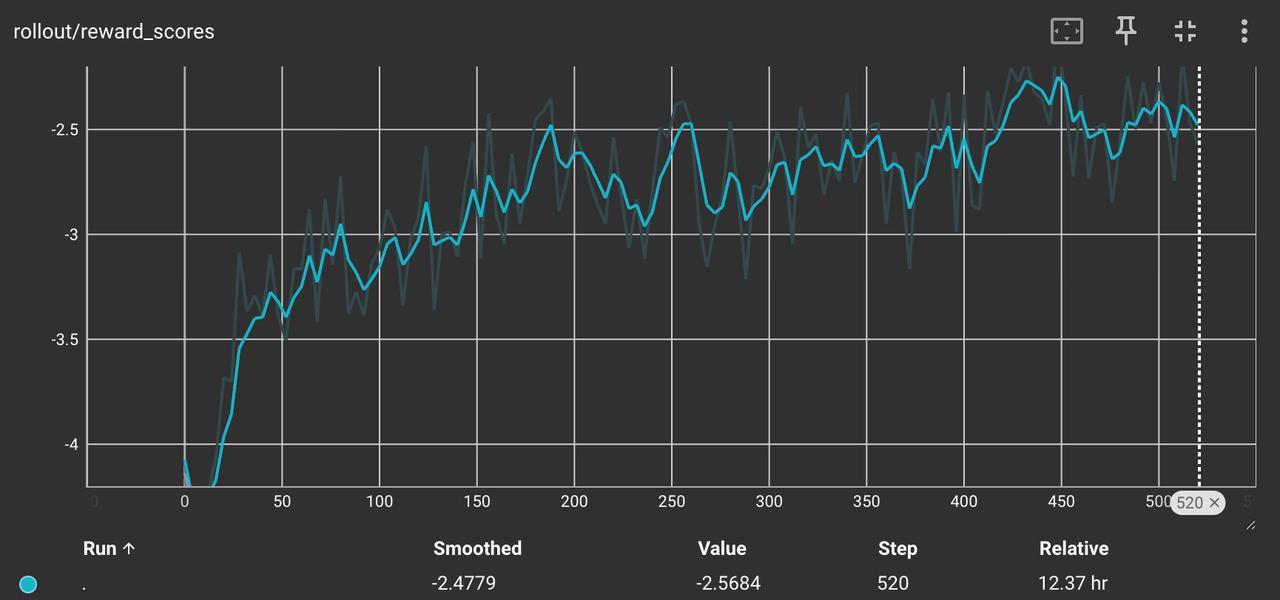
Moonlight-16B GRPO reward 曲线