在 Franka 上使用 HG-DAgger#
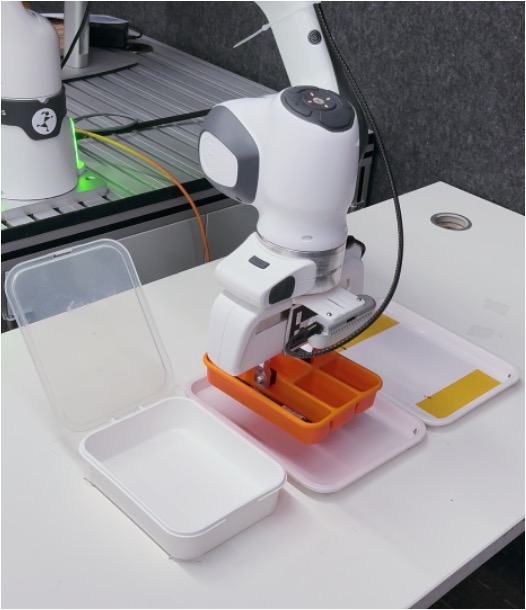
用于采集干预数据并在线训练 Franka 策略的 Human-Gated DAgger 流程。#
使用 Human-Gated DAgger 训练 Franka 真机策略。你将采集干预数据,计算 OpenPI 归一化统计,运行 SFT,然后启动在线 HG-DAgger。在线阶段使用 LeRobot 归档完整的成功 episode:未接管帧保留策略实际执行动作,接管帧保存人工动作和 intervene_flag。启用 only_save_expert: True 后,训练只采样非 padding 帧全部由人工接管的 action chunk。
概览#
用人工门控干预在线提升 Franka 真机策略。
OpenPI π₀ / π₀.₅
SFT · HG-DAgger
Real-world PnP
Franka · PICO
任务#
任务 |
配置 / 入口 |
说明 |
|---|---|---|
Collection |
|
使用 PICO 采集真机示教。 |
SFT |
|
训练 student 初始化。 |
HG-DAgger |
|
使用 online LeRobot 归档完整成功轨迹,并仅用全接管 action chunk 训练。 |
观测与动作#
字段 |
说明 |
|---|---|
Observation |
Franka 相机帧与可选机器人状态。 |
Action |
OpenPI action 解码为 Franka 真机控制。 |
Reward |
人工门控干预信号与任务结果。 |
Prompt |
OpenPI 数据集/配置 metadata 中的任务文本。 |
安装#
真实世界流程的不同节点需要 不同的软件环境:
机器人 / env 节点:使用 Franka 真机强化学习 中的 Franka 控制节点环境。
训练 / rollout 节点:使用与模拟器 DAgger 具身策略的 DAgger 训练 相同的环境。
机器人 / Env 节点#
按 Franka 真机强化学习 的「安装」章节准备机器人节点:直接安装基于 Franky 的 franka 环境,或使用 Franka Docker 镜像中的 franky venv,并让 LIBFRANKA_VERSION 与固件匹配。启动 Ray 前先激活该环境。本示例在独立的 GPU 节点上运行 OpenPI actor 和 rollout。
训练 / Rollout 节点#
该节点使用与模拟器 Pi0 DAgger 相同的软件环境。
选项 1:Docker 镜像
docker run -it --rm --gpus all \
   --shm-size 20g \
   --network host \
   --name rlinf \
   -v .:/workspace/RLinf \
   rlinf/rlinf:agentic-rlinf0.4-maniskill_libero
   # 如果需要国内加速下载镜像,可以使用:
   # infinigence-ai-registry.cn-beijing.cr.aliyuncs.com/rlinf/rlinf:agentic-rlinf0.4-maniskill_libero
进入容器后执行:
source switch_env openpi
选项 2:自定义环境
# 为提高国内依赖安装速度,可以添加 `--use-mirror` 参数。
bash requirements/install.sh embodied --model openpi --env maniskill_libero
source .venv/bin/activate
集群设置#
在启动采集或训练任务之前,请先完成 Franka 真机强化学习 中介绍的 Ray 集群配置。
通常训练 / rollout 节点作为 Ray head(RLINF_NODE_RANK=0),Franka 控制
节点作为 worker(RLINF_NODE_RANK=1)。
# 在训练 / rollout 节点
export RLINF_NODE_RANK=0
ray start --head --port=6379 --node-ip-address=<head_node_ip>

# 在机器人 / env 节点
export RLINF_NODE_RANK=1
ray start --address='<head_node_ip>:6379'
Ray 会在启动时记录当前 Python 解释器与环境变量,因此务必在 ray start
之前完成对应环境的 source。
运行#
1. 采集带人工引导的真实数据#
从 examples/embodiment/config/realworld_collect_data_pico.yaml 开始。对于抓放
任务,需要将环境从 peg insertion 切换为 bin relocation:
defaults:
  - env/realworld_bin_relocation@env.eval
  - override hydra/job_logging: stdout
然后填写机器人配置和 PICO publisher 地址,并将导出格式设置为 LeRobot:
cluster:
  node_groups:
    - label: franka
      node_ranks: 0
      hardware:
        type: Franka
        configs:
          - robot_ip: ROBOT_IP
            node_rank: 0

env:
  eval:
    teleop: pico
    pico:
      zmq_addr: "ipc:///tmp/vr_data.ipc"
      hand: "right"
      control_trigger: "grip"
      control_threshold: 0.85
      gripper_close_button: "A"
      gripper_open_button: "B"
      position_scale: 1.0
      rotation_scale: 1.0
      max_stale_s: 0.2
      calibration:
        enabled: True
        required: True
        auto_calibrate_on_start: True
        button: "trigger"
    override_cfg:
      target_ee_pose: [0.50, 0.00, 0.01, 3.14, 0.0, 0.0]
      success_hold_steps: 1
      camera_serials: ["CAMERA_SERIAL_1", "CAMERA_SERIAL_2"]
    data_collection:
      enabled: True
      save_dir: ${runner.logger.log_path}
      export_format: [replay_buffer, lerobot_dataset]
      only_success: True
      robot_type: "panda"
      fps: 10
启动采集前,请按照 Franka 真机使用 VR 遥操作设备 启动并检查 PICO 数据流。上述 ipc://
地址要求 publisher 与 env worker 运行在同一台机器;若二者位于不同机器,请改为
tcp://<publisher_ip>:<port>。
使用你复制后的配置启动采集:
bash examples/embodiment/collect_data.sh my_realworld_pnp_collect
遥操作过程中,同一次运行会写出:
replay-buffer 轨迹到
logs/{timestamp}/demo_buffer/LeRobot 数据到
logs/{timestamp}/lerobot_dataset/
关于采集格式,参见 数据采集。
2. 计算归一化统计#
在进行 SFT 或 HG-DAgger 之前,先为采集得到的 LeRobot 数据集计算 OpenPI 归一化统计:
export HF_LEROBOT_HOME=/path/to/lerobot_root
python toolkits/lerobot/calculate_norm_stats.py \
    --config-name pi0_realworld \
    --repo-id realworld_franka_bin_relocation
这里使用的数据集根目录和数据集 id,需要与后续 SFT 保持一致。更多 OpenPI 数据集说明可参考 OpenPI 监督微调。
3. 运行 OpenPI SFT#
启动前,先修改 examples/sft/config/realworld_bin_relocation_sft_openpi.yaml:
data:
  train_data_paths: "/path/to/realworld-franka-bin-relocation-dataset"

actor:
  model:
    model_path: "/path/to/pi0-model"
    openpi:
      config_name: "pi0_realworld"
然后执行:
bash examples/sft/run_vla_sft.sh realworld_bin_relocation_sft_openpi
SFT 导出的 checkpoint 会作为在线阶段的学生模型初始化。更多 OpenPI SFT 细节 可参考 OpenPI 监督微调。
4. 在真机上运行异步 HG-DAgger#
修改 examples/embodiment/config/realworld_pnp_dagger_openpi.yaml,使其与你的
集群、相机、目标位姿与 checkpoint 一致:
cluster:
  num_nodes: 2
  node_groups:
    - label: "train"
      node_ranks: 0
    - label: franka
      node_ranks: 1
      hardware:
        type: Franka
        configs:
          - robot_ip: ROBOT_IP
            node_rank: 1

runner:
  ckpt_path: "/path/to/sft_checkpoint/full_weights.pt"

algorithm:
  dagger:
    only_save_expert: True
    online_lerobot:
      enabled: True
      only_success: True
      robot_type: "panda"
      fps: 10
      finalize_interval: 1
      data_path: ${runner.logger.log_path}/online_lerobot
      rolling_lerobot_window_size: 50000
      min_frames: 1
      lerobot_num_workers: 0

env:
  train:
    smooth_intervene: True
    teleop: pico
    pico:
      zmq_addr: "ipc:///tmp/vr_data.ipc"
      hand: "right"
      control_trigger: "grip"
      control_threshold: 0.85
      gripper_close_button: "A"
      gripper_open_button: "B"
      position_scale: 1.0
      rotation_scale: 1.0
      max_stale_s: 0.2
      calibration:
        enabled: True
        required: True
        auto_calibrate_on_start: True
        button: "trigger"
    override_cfg:
      target_ee_pose: [0.50, 0.00, 0.01, 3.14, 0.0, 0.0]
      camera_serials: ["CAMERA_SERIAL_1", "CAMERA_SERIAL_2"]
  eval:
    teleop: none
    override_cfg:
      target_ee_pose: [0.50, 0.00, 0.01, 3.14, 0.0, 0.0]
      camera_serials: ["CAMERA_SERIAL_1", "CAMERA_SERIAL_2"]

rollout:
  model:
    model_path: "/path/to/pi0-model"

actor:
  model:
    model_path: "/path/to/pi0-model"
    openpi:
      config_name: "pi0_realworld"
online_lerobot.enabled: True 表示启用在线 LeRobot 数据链路。env worker 按 episode 收集 rollout,并将满足过滤条件的 episode 发送给 actor;actor 将其加入 RollingLeRobotDataset 进行训练,因此在线训练不再使用 trajectory replay buffer。
smooth_intervene: True 会在 PICO 接管持续到 action chunk 最后一帧时绕过下一次策略推理。env worker 使用 dummy chunk 持续驱动遥操 wrapper,并在松开 grip 或 episode 结束后恢复正常推理。该模式仅支持 PICO:env.train.teleop 必须是 pico;同时要求每个 env worker pipeline stage 只运行一个环境。env.eval.teleop: none 表示评测阶段只运行策略,不启用人工接管。
only_success: True 会丢弃失败 episode。only_save_expert: True 仍将完整的
成功 episode 保存在 LeRobot 归档中,但在线 sampler 只暴露 action chunk 内所有非
padding 帧均满足 intervene_flag=True 的起点。当 num_action_chunks: 1 时,
该规则退化为逐帧过滤。每个成功 episode 内:
未接管帧仍保留在物理归档中,但不会作为 expert-only 训练样本暴露;
人工接管帧保存接管设备实际执行的动作,并带有
intervene_flag=True;finalize_interval: 1表示每完成一个成功 episode 就立即写出一个 LeRobot shard;rolling_lerobot_window_size: 50000表示在线训练只从最近 50,000 个符合专家 条件的逻辑 chunk 起点采样,较早的 shard 仍保留在磁盘中。
真机 DAgger 配置不包含 beta 相关字段,因为没有配置 rollout.expert_model。Beta 只用于模型 expert 和 student 之间的动作混合;真机人工接管由 env.train 中启用的 PICO intervention wrapper 决定。
在 Ray head 节点上启动 HG-DAgger:
bash examples/embodiment/run_realworld_async.sh realworld_pnp_dagger_openpi
可视化与监控#
1. TensorBoard 日志
tensorboard --logdir ./logs
2. 在线 LeRobot 数据写入
每个成功 episode 会写到本次运行日志目录:
logs/<timestamp>-realworld_pnp_dagger_openpi/online_lerobot/rank_0/id_0/
logs/<timestamp>-realworld_pnp_dagger_openpi/online_lerobot/rank_0/id_1/
...
失败 episode 不会进入在线 dataset。
3. 推荐关注的监控指标
train/dagger/actor_loss:基于 expert-only action chunk 计算的监督损失。train/lerobot_dataset/total_episodes:actor 当前已接收的成功 episode 数量。train/lerobot_dataset/physical_frames:已接收的 LeRobot 物理帧数量。train/lerobot_dataset/logical_samples:rolling window 内符合专家条件、可训练的 chunk 起点数。train/lerobot_dataset/num_sub_datasets:当前加载的 LeRobot shard 数量。train/actor/lr:学习率。train/actor/grad_norm:梯度范数。