
OpenVLA-OFT 强化学习训练#
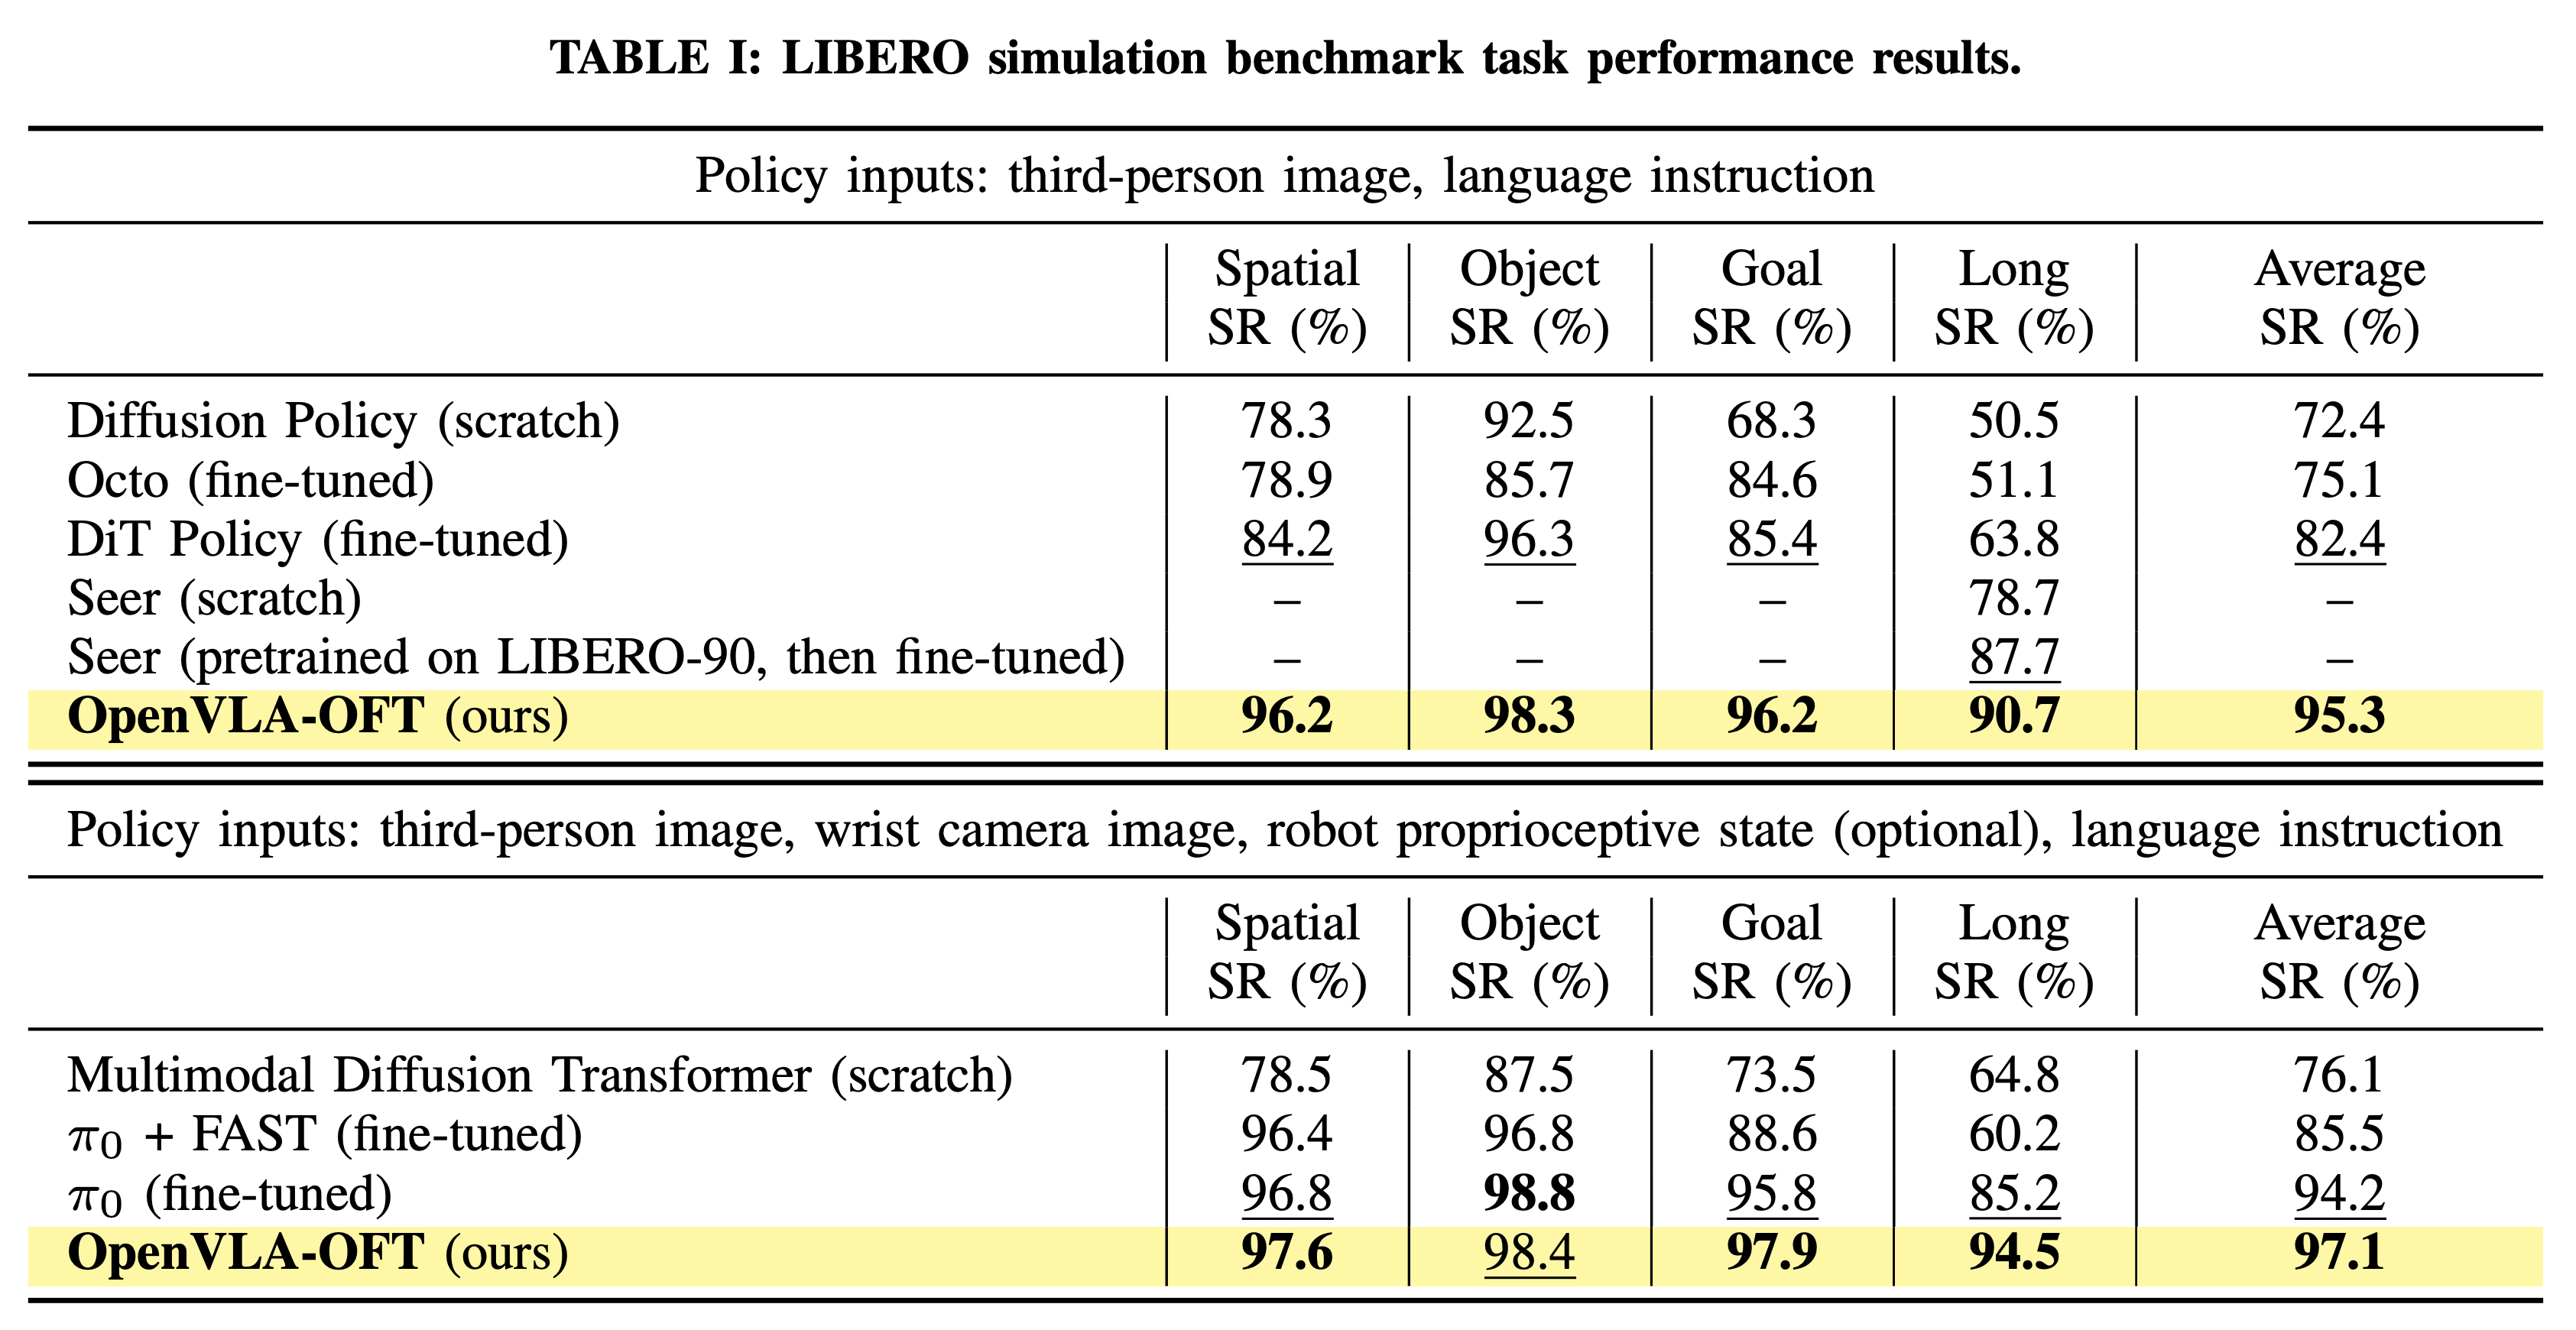
原始 OFT 微调研究的 LIBERO 结果(图片来源:OpenVLA-OFT 项目)。#
使用 RLinf 对 OpenVLA-OFT 进行强化学习微调。本页先介绍 NVIDIA 上的 LIBERO + GRPO 训练流程,再说明如何在 AMD ROCm、华为昇腾 CANN 和摩尔线程 MUSA 上使用同一模型运行 LIBERO 或 ManiSkill。原始 OpenVLA 模型的训练流程见 基于 ManiSkill 的强化学习训练。
概览#
选择与任务匹配的 checkpoint 和配置,在 LIBERO 上训练 OpenVLA-OFT。其他环境的训练流程见下方链接的模拟器页面。
LIBERO · ManiSkill · RoboTwin · MetaWorld · BEHAVIOR · OpenSora · Wan
PPO · GRPO
语言条件操作任务
NVIDIA CUDA · AMD ROCm · 华为昇腾 CANN · 摩尔线程 MUSA (LIBERO · ManiSkill)
env/success_once。任务#
可先运行 LIBERO-Goal。其他模拟器的完整流程保留在各自页面中。
环境 |
任务 / 套件 |
配置 / 权重 |
重点 |
|---|---|---|---|
Goal |
|
目标条件操作。 |
|
Plate-25 |
|
桌面操作。 |
|
Place empty cup |
|
双臂操作。 |
|
MT50 |
|
多任务操作。 |
|
家居任务 |
|
长程活动。 |
|
LIBERO Spatial |
|
使用世界模型训练。 |
观测与动作#
LIBERO 训练流程根据图像和任务提示生成动作块。
字段 |
说明 |
|---|---|
Observation |
模型配置指定的 RGB 图像。 |
Action |
由 7 维末端与夹爪动作组成的动作块。 |
Reward |
按训练配置缩放的 LIBERO 任务成功奖励。 |
Prompt |
当前任务的自然语言指令。 |
安装#
默认流程使用下方的 NVIDIA 安装步骤。AMD、昇腾或 MUSA 用户请先完成 对应后端的安装,再下载模型。
首先,克隆 RLinf 仓库:
# 为提高国内下载速度,可以使用镜像:
# git clone https://gh-proxy.com/github.com/RLinf/RLinf.git
git clone https://github.com/RLinf/RLinf.git
cd RLinf
然后,使用下列两种方式之一准备依赖:预构建的 Docker 镜像(推荐)或自定义环境。
通用的安装流程(前置依赖、GPU 驱动、镜像内置的 switch_env 工具、镜像加速、常见问题排查)
在 安装说明 中统一说明;本方案中的命令仅在 Docker
镜像标签和 --env 取值上有所不同。
在仓库根目录启动 NVIDIA 容器:
docker run -it --rm --gpus all \
   --shm-size 20g --network host \
   -v "$PWD":/workspace/RLinf -w /workspace/RLinf \
   rlinf/rlinf:agentic-rlinf0.4-maniskill_libero bash
source switch_env openvla-oft
也可以在本地仅安装 OpenVLA-OFT 和 LIBERO 的依赖:
bash requirements/install.sh embodied --model openvla-oft --env libero
source .venv/bin/activate
下载模型#
下载该配置对应的 LIBERO-Goal SFT checkpoint:
hf download Haozhan72/Openvla-oft-SFT-libero-goal-traj1 \
   --local-dir checkpoints/Openvla-oft-SFT-libero-goal-traj1
下载完成后,在配置 YAML 中指向该检查点——为 rollout 与 actor 两处模型设置相同的路径:
rollout:
   model:
      model_path: /path/to/downloaded-checkpoint
actor:
   model:
      model_path: /path/to/downloaded-checkpoint
在 examples/embodiment/config/libero_goal_grpo_openvlaoft.yaml 中设置这些路径。保留 actor.model.unnorm_key: libero_goal_no_noops,以匹配 checkpoint 的动作统计数据。其他套件需要对应的 checkpoint 和 key,详见 基于 LIBERO 的强化学习训练。
运行#
激活模型环境并设置路径后,启动 LIBERO-Goal 训练:
ROBOT_PLATFORM=LIBERO bash examples/embodiment/run_embodiment.sh libero_goal_grpo_openvlaoft
脚本加载指定的 YAML,按 cluster.component_placement 创建 actor、rollout 和环境 worker,然后启动 GRPO。请按设备资源调整 placement 和 batch size,参见 Worker 放置策略 与 常见问题。
在不同硬件后端上运行#
NVIDIA 使用上面的安装与启动流程。AMD ROCm、华为昇腾 CANN 和摩尔线程 MUSA 都通过共用平台安装器、scheduler 设备 API 与模型运行路径支持 OpenVLA-OFT 在 LIBERO 和 ManiSkill 上运行。概览中的其他环境有各自的硬件要求。
AMD ROCm#
可以启动 ROCm 容器,也可以在已安装 ROCm 的宿主机上直接安装。
ROCm LIBERO 容器需要访问 AMD 内核与渲染设备。在宿主机的仓库根目录启动容器:
docker run -it --rm \
   --device=/dev/kfd --device=/dev/dri --group-add video \
   --ipc=host --shm-size 20g --network host \
   -v "$PWD":/workspace/RLinf -w /workspace/RLinf \
   rlinf/rlinf:agentic-rlinf0.4-maniskill_libero-rocm7.2 bash
该镜像基于 ROCm 7.2,包含全部 ManiSkill 与 LIBERO 模型环境。此前仅含 LIBERO 的镜像仍可使用,tag 为 agentic-rlinf0.3-libero-rocm6.4 与 agentic-rlinf0.3-libero-rocm7.2.3。中国大陆用户可使用 infinigence-ai-registry.cn-beijing.cr.aliyuncs.com/rlinf/rlinf 下的同名 tag。
如需从当前代码构建包含这些模型的共用镜像,在宿主机运行以下命令,再将上面的容器镜像替换为 rlinf:embodied-maniskill_libero-rocm7.2:
DOCKER_BUILDKIT=1 docker build -f docker/Dockerfile \
   --build-arg PLATFORM=amd \
   --build-arg ROCM_VER=7.2 \
   --build-arg 'ROCM_ARCHS=gfx90a;gfx942' \
   --build-arg BUILD_TARGET=embodied-maniskill_libero \
   -t rlinf:embodied-maniskill_libero-rocm7.2 .
警告
ROCM_ARCHS 必须与目标 GPU 匹配。Docker 构建期间可能无法访问设备,flash-attn 等扩展需要显式指定架构。Dockerfile 会将这些值传给 ROCm 构建工具。
发布镜像已经包含该模型环境:
source switch_env openvla-oft
若宿主机已安装 ROCm,也可以直接安装依赖:
bash requirements/install.sh --platform amd --rocm 6.4 embodied --model openvla-oft --env libero
source .venv/bin/activate
省略 --rocm 可自动检测已安装的版本;中国大陆用户可添加 --use-mirror。
华为昇腾 CANN#
可以使用容器,也可以在已具备 CANN 和 NPU 驱动的宿主机上安装。
昇腾 LIBERO 镜像需要访问宿主机的 NPU 驱动。在宿主机的仓库根目录运行以下命令,将驱动目录挂载到容器中:
docker run -it --rm \
   --privileged \
   --ipc=host \
   --shm-size 20g \
   --network host \
   -v /usr/local/dcmi:/usr/local/dcmi \
   -v /usr/local/Ascend/driver:/usr/local/Ascend/driver \
   -v /etc/ascend_install.info:/etc/ascend_install.info \
   -v /var/log/npu:/usr/slog \
   -v /usr/local/sbin/npu-smi:/usr/local/sbin/npu-smi \
   -v /sys/fs/cgroup:/sys/fs/cgroup:ro \
   -v "$PWD":/workspace/RLinf \
   -w /workspace/RLinf \
   rlinf/rlinf:agentic-rlinf0.4-maniskill_libero-cann9.1.1 bash
该镜像基于面向 910B 的 CANN 9.1.1,包含全部 ManiSkill 与 LIBERO 模型环境。上面的 tag 同时包含 arm64 与 amd64 两个版本,Docker 会按宿主机架构自动选择;如需指定单一架构,可使用带 -arm64 或 -amd64 后缀的 tag。此前仅含 LIBERO 的镜像仍可使用,tag 为 agentic-rlinf0.3-libero-cann9.0。中国大陆用户可使用 infinigence-ai-registry.cn-beijing.cr.aliyuncs.com/rlinf/rlinf 下的同名镜像 tag。若要指定可用的 NPU,可将 --privileged 替换为以下设备参数,并为每张需要使用的 NPU 添加一项 /dev/davinciN:
--device=/dev/davinci_manager
--device=/dev/devmm_svm
--device=/dev/hisi_hdc
--device=/dev/davinci0
如需从当前代码构建镜像,在宿主机执行以下命令,再将上面启动命令中的镜像替换为 rlinf-maniskill_libero-cann9:
DOCKER_BUILDKIT=1 docker build -f docker/Dockerfile \
   --build-arg PLATFORM=ascend \
   --build-arg CANN_VER=9.1.1-910b \
   --build-arg UBUNTU_VER=22.04 \
   --build-arg BUILD_TARGET=embodied-maniskill_libero \
   -t rlinf-maniskill_libero-cann9 .
CANN_VER 包含昇腾基础镜像 tag 中的硬件后缀。也可以通过 Dockerfile 的 ASCEND_BASE_IMAGE 参数指定完整的基础镜像地址。
进入已发布的 RLinf 容器后,激活模型环境:
source switch_env openvla-oft
本地安装时,通过昇腾选项安装 CPU PyTorch 及匹配的 torch-npu:
bash requirements/install.sh --platform ascend embodied --model openvla-oft --env libero
source .venv/bin/activate
中国大陆用户可添加 --use-mirror。安装脚本在昇腾上会跳过 CUDA flash-attention 的构建。
在昇腾 950 NPU 上本地安装时,在 embodied 之前添加 --torch 2.11.0。昇腾安装脚本默认使用 PyTorch 和 torch-npu 2.6.0,而 torch-npu 2.6.0 初始化 950 NPU 时会报 Unsupported soc version。PyTorch 和 torch-npu 2.11.0 已在 NPU 驱动 25.7.rc1、CANN 9.1.1 的昇腾 950 上验证通过。
摩尔线程 MUSA#
在摩尔线程容器内运行。安装器会复用镜像中的 MUSA 版 PyTorch 与 torch_musa,避免被通用 torch wheel 覆盖。
MUSA 使用摩尔线程 training-suite 镜像中相互匹配的 PyTorch 与 torch_musa。通过 mthreads runtime 启动容器,才能在容器内访问驱动库与设备:
export MUSA_IMAGE=registry.mthreads.com/mcctest/ai/training-suite:v2.1.5-musa4.3.7
docker run -it --rm --runtime=mthreads \
   --ipc=host --shm-size=100g \
   -e MTHREADS_VISIBLE_DEVICES=all \
   -v "$PWD":/workspace/RLinf -w /workspace/RLinf \
   "$MUSA_IMAGE" bash
预装 LIBERO 模型环境的镜像已发布为 rlinf/rlinf:agentic-rlinf0.4-maniskill_libero-musa,它基于同一个 training-suite 镜像,启动方式相同。ManiSkill 仍需要下文所述的厂商仿真器包,因此 ManiSkill 请使用厂商镜像。
安装模型环境前,先确认设备可用:
mthreads-gmi
python -c "import torch, torch_musa; print(torch.musa.device_count())"
警告
若设备数量为零,请先解决设备访问问题。保留镜像中配套的 PyTorch 与 torch_musa,安装通用 torch wheel 可能覆盖 MUSA 版本。具身示例使用 Hugging Face rollout 后端,因为 MUSA 安装会跳过仅支持 CUDA 的 vLLM 与 SGLang kernel。
如需从当前代码构建 RLinf 镜像,在宿主机使用 BuildKit:
DOCKER_BUILDKIT=1 docker build -f docker/Dockerfile \
   --build-arg PLATFORM=musa \
   --build-arg MUSA_VER=v2.1.5-musa4.3.7 \
   --build-arg BUILD_TARGET=embodied-maniskill_libero \
   -t rlinf:embodied-maniskill_libero-musa .
MUSA 驱动库由 runtime 注入,因此设备感知容器启动前,镜像构建步骤不能导入 torch。BuildKit 还能避免解析无关的 CUDA 与 ROCm 基础镜像阶段。
进入容器后,选择 MUSA 平台安装 OpenVLA-OFT:
bash requirements/install.sh --platform musa embodied --model openvla-oft --env libero
source .venv/bin/activate
中国大陆用户可添加 --use-mirror。RLinf 会检测 MUSA 设备,并沿用其他 GPU 后端的 placement 配置完成分配。
在 AMD、昇腾或 MUSA 上启动 LIBERO#
完成其中一种后端的安装后,按前面的说明下载 LIBERO-Goal checkpoint 并设置模型路径。在同一 shell 中启用软件渲染。
在 AMD、华为昇腾和摩尔线程上运行 LIBERO 时,使用 CPU 渲染。在已激活的模型环境中设置以下变量,再启动训练:
export MUJOCO_GL=osmesa
export PYOPENGL_PLATFORM=osmesa
export ROBOT_PLATFORM=LIBERO
run_embodiment.sh 会保留这些变量。安装脚本通过 requirements/sys_deps.sh 安装所需的 libosmesa6 系统库。
警告
直接启动 Python 时也需要设置这两个渲染变量。软件渲染会占用 CPU 资源,增加 rollout 并行度前,应按主机能力调整环境数量。
启动已配置的 GRPO 训练:
bash examples/embodiment/run_embodiment.sh libero_goal_grpo_openvlaoft
在 AMD、昇腾或 MUSA 上运行 ManiSkill#
AMD 与昇腾使用 OpenVLA-OFT 的 ManiSkill + LIBERO 组合环境。根据所选模型 accelerator 执行对应命令:
# AMD ROCm
bash requirements/install.sh --platform amd --rocm 6.4 embodied --model openvla-oft --env maniskill_libero

# 华为昇腾 CANN
bash requirements/install.sh --platform ascend embodied --model openvla-oft --env maniskill_libero

source .venv/bin/activate
MUSA 需要保留厂商模拟器包,并在厂商镜像中添加 OpenVLA-OFT 模型环境:
MUSA 上的 ManiSkill 需要使用包含修改版 SAPIEN 与匹配 ManiSkill 包的厂商镜像。在仓库根目录启动:
export MUSA_IMAGE=registry.mthreads.com/lgpublic/rlinf:rlinf0.2-maniskill_libero_openpi-0428-jingdong
docker run -it --rm --runtime=mthreads \
   --ipc=host --shm-size=100g \
   -e MTHREADS_VISIBLE_DEVICES=all \
   -v "$PWD":/workspace/RLinf -w /workspace/RLinf \
   "$MUSA_IMAGE" bash
download_assets --assets maniskill
警告
公开的 sapien 与 ManiSkill v3.0.0b22 无法组成可用的 MUSA 模拟器环境。请保留镜像中的厂商包;添加其他模型环境时使用 --env libero,避免 install.sh 替换这些模拟器包。
bash requirements/install.sh --platform musa embodied --venv openvla-oft --model openvla-oft --env libero
source openvla-oft/bin/activate
三种非 CUDA 后端均使用以下 CPU simulation 配置:
ManiSkill 的 PhysX 仿真可以在 CPU 上运行,不依赖承载模型的 accelerator。请在所选 ManiSkill 配置的 env.train 与 env.eval 中使用以下设置:
env:
  train:
    total_num_envs: 2
    init_params:
      sim_backend: cpu
      render_backend: "pci:0000:00:00.0"
  eval:
    total_num_envs: 2
    init_params:
      sim_backend: cpu
      render_backend: "pci:0000:00:00.0"
sim_backend: cpu 会将 PhysX 移到 CPU,VLA 仍在所选 accelerator 上运行。render_backend 通过完整 PCI 地址选择 SAPIEN Vulkan renderer;RLinf 会在创建环境前保留 pci:<domain>:<bus>:<slot>.<function> 格式。若容器内的 renderer 使用其他地址,请替换示例值。
在 AMD 平台上,install.sh 会根据 GPU ISA 选择 Vulkan 驱动并写入环境:Radeon GPU 使用 Mesa 的 RADV 驱动渲染;CDNA accelerator(如 Instinct 系列)则使用 Mesa 的 lavapipe 软件光栅化器,因为 RADV 无法在这类卡上渲染。CPU 渲染比硬件渲染占用更多 CPU 时间。
警告
CPU simulation backend 无法在单个进程内向量化多个环境。请将训练与评测的 total_num_envs 分别设为对应 env worker 的 rank 数量,使每个 worker 只运行一个环境。
下载 RLinf/RLinf-OpenVLAOFT-ManiSkill-Base-Main 及其 LoRA adapter,在 examples/embodiment/config/maniskill_ppo_openvlaoft.yaml 中设置 model_path 与 lora_path,并根据可用设备调整 placement 与 batch size 后启动 PPO:
bash examples/embodiment/run_embodiment.sh maniskill_ppo_openvlaoft
可视化与结果#
在训练日志中观察 env/success_once。指标定义见 训练指标,已发布的训练结果见 LIBERO 结果。独立评测请按 LIBERO 评测指南 操作。